如果不再逐块判断,会怎样?
一段视频可能逐渐出错,即使其中没有哪一个块看起来明显有问题。
这是自回归视频生成面临的一个特殊挑战。每个新块都建立在之前的内容之上,因此外观或运动中的微小误差会随时间累积。较小的模型能快速生成这些块,但独自运行得越久,视频就越可能偏离原来的轨迹。定期让较大的模型介入会有所帮助,难点在于决定何时介入。
直观的办法是检查每个草稿块,并在感知分数低于阈值时调用较大的模型。这就是在线路由的思路:只在需要时使用昂贵的计算资源。
但我们的实验发现了意料之外的结果。在 Krea Realtime 的一项实测配置中,在线路由占据了总生成时间的 37%。然而,在匹配的接受率下,它做出的决定相比随机接受,并未带来统计显著的质量提升。更糟的是,路由器有时会让草稿模型连续生成二十多个块,而目标模型始终没有介入,微小误差因而在视频中不断累积。
这提示我们换一种方式看待问题。关键或许不是哪些单独的块需要大模型,而是小模型最多可以连续运行多久。
这正是 SpecAR 的核心:把目标模型的调用位置视为调度问题,而不是一连串运行时决策。
01 / 观看
看看 SpecAR 如何先完成
两段视频使用同一提示词和起始帧。竞速按各方法测得的平均生成时间播放:SpecAR 完成时,目标模型仍在生成。选择其他场景即可自动播放;切换到“同一帧”可按相同视频时间比较两种输出。
B200 平均生成时间:SpecAR 18.5 秒;仅目标模型 51.8 秒。以 1× 真实时间演示。
滚动到这里时,竞速会自动开始。
02 / 方法
目标块应该放在哪里?
假设要生成一段由 36 个块组成的视频,但预算只允许调用大模型七次。这七次调用应该放在哪里?
可以把它们集中在开头、随机分散,或者借助感知路由器边生成边决定。但这些做法可能留下很长的区间,让小模型一直独自生成。由于每个块都会成为下一个块的上下文,这段区间早期产生的误差可能传播到后续所有内容。
SpecAR 采用另一种方法:尽可能均匀地分布目标块。
对于 36 个块和七次目标模型调用,这保证草稿模型最多只能独自连续生成五个块。在相同预算下,任何其他放置方式都无法保证更短的最长连续草稿段。调度在生成前就已确定,不需要训练,也不增加逐块打分开销。
这一保证针对的是目标模型的介入频率,并不直接保证视频质量。如此简单的调度能否真正超越自适应路由器,仍须由实验回答。
试着移动下方的目标块。将它们集中或分散,看看最长的连续草稿段如何变化。
你达到了理论最小值。
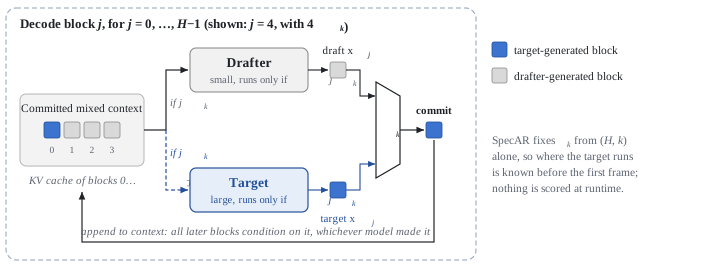
对于一个共有 H 个块、目标块预算为 k的生成过程,SpecAR 将目标块(含第 0 块)近似等间隔放置。每个块只由一个模型生成,并写入之后所有块共享的上下文。最长连续草稿段至多为 ⌈H/k⌉ − 1 个块,即理论最小值。
查看论文中的解码示意图
03 / 结果
固定调度能超越自适应路由器吗?
均匀分布提供了一项有用的保证:草稿模型不会在目标模型介入前连续运行太久。但缩短最长草稿段,不一定就能生成更好的视频。自适应路由器能利用固定调度忽略的信息;原则上,这应该是它的优势。
因此,我们将 SpecAR 与 SDVG 进行了比较。SDVG 使用感知分数来决定何时调用目标模型。
结果出人意料。在全部三个测试的目标块预算下,SpecAR 的速度和实测质量指标都更好。在单张 H100 上,它在 Krea Realtime 14B 上比 SDVG 快 1.63–1.73 倍,在 Helios 14B 上快 1.10–1.84 倍;各测试运行点的 VisionReward 和 VBench Quality-6 分数也都更高。
例如,在 Krea Realtime 上使用七个目标块时,SpecAR 在 42.9 秒内完成,而 SDVG 需要 70.3 秒。它的 VisionReward 分数也更高:0.0972 对 0.0886。
路由器掌握更多信息,也做出更多决策。但在这些实验中,两者都没有转化为优势。
耗时 32.8 秒;仅目标模型为 87.6 秒,SDVG 为 56.8 秒。Quality-6:SpecAR 77.25、SDVG 76.95、仅目标模型 78.06。
从 Hopper 到 Blackwell
有用的加速效果应该能够跨越单一硬件配置。因此,我们使用 Krea Realtime 14B,在两代 NVIDIA GPU 上评估了 SpecAR:Hopper(H100)和 Blackwell(B200)。
在单张 H100 上,SpecAR 将生成时间从 87.6 秒缩短至 32.8 秒,相比仅运行目标模型快 2.67 倍。在单张 B200 上,生成时间从 51.8 秒降至 18.5 秒,实现 2.81 倍加速。在全部三个测试的目标块预算下,两种 GPU 的加速比都超过 2 倍。
Blackwell 的结果还跨过了一个重要门槛。SpecAR 达到 23.1 FPS 的生成速度,超过视频的 16 FPS 播放帧率。即使把更多块分配给目标模型,吞吐量仍保持在 18.0 到 19.7 FPS。在这三种配置中,模型生成帧的速度都快于播放速度。
查看 H100 与 B200 的耗时、FPS 和加速比
| 方法 | 耗时 | FPS | 加速比 |
|---|---|---|---|
| 仅目标模型 | 87.6 s | 4.9 | 1.00× |
| SpecAR, k = 2 | 32.8 s | 13.0 | 2.67× |
| SpecAR, k = 5 | 39.0 s | 10.9 | 2.25× |
| SpecAR, k = 7 | 42.9 s | 9.9 | 2.04× |
| 方法 | 耗时 | FPS | 加速比 |
|---|---|---|---|
| 仅目标模型 | 51.8 s | 8.2 | 1.00× |
| SpecAR, k = 2 | 18.5 s | 23.1 | 2.81× |
| SpecAR, k = 5 | 21.6 s | 19.7 | 2.40× |
| SpecAR, k = 7 | 23.7 s | 18.0 | 2.19× |
查看完整基准测试表
| 耗时 | 加速比 | VisionReward | Quality-6 | |
|---|---|---|---|---|
| 仅目标模型 | 87.6 s | 1.00× | 0.0914 | 78.06 |
| k = 2 | ||||
| SDVG | 56.8 s | 1.54× | 0.0855 | 76.95 |
| SpecAR | 32.8 s | 2.67× | 0.0876 | 77.25 |
| k = 5 | ||||
| SDVG | 63.5 s | 1.38× | 0.0872 | 77.01 |
| SpecAR | 39.0 s | 2.25× | 0.0943 | 77.32 |
| k = 7 | ||||
| SDVG | 70.3 s | 1.25× | 0.0886 | 76.91 |
| SpecAR | 42.9 s | 2.04× | 0.0972 | 77.85 |
| 耗时 | 加速比 | VisionReward | Quality-6 | |
|---|---|---|---|---|
| 仅目标模型 | 2911.5 s | 1.00× | 0.1487 | 78.98 |
| k = 2 | ||||
| SDVG | 507.3 s | 5.74× | 0.1112 | 75.89 |
| SpecAR | 276.2 s | 10.54× | 0.1223 | 77.05 |
| k = 5 | ||||
| SDVG | 665.4 s | 4.38× | 0.1156 | 75.88 |
| SpecAR | 509.6 s | 5.71× | 0.1270 | 77.17 |
| k = 7 | ||||
| SDVG | 735.8 s | 3.96× | 0.1199 | 75.69 |
| SpecAR | 666.5 s | 4.37× | 0.1375 | 77.73 |
Quality-6 是仅包含六个维度的 VBench 质量分数。平均耗时和 VisionReward 来自论文。
04 / 快速开始
亲自运行 SpecAR
这些结果背后的代码已公开。我们发布的 SpecAR 支持 Krea Realtime 14B 和 Helios 14B。你可以在单张受支持的 GPU 上生成视频、调整目标块预算,并探索速度与质量之间的权衡。
你可以从命令行直接运行 SpecAR,也可以通过 ComfyUI 集成使用可视化工作流。两种方式都体现了同一个核心想法:控制目标模型运行的频率,而无需依赖在线路由器。
公开代码和权重可在单张 NVIDIA Hopper GPU(H100 80GB 或 H200 141GB)上运行,使用 Python 3.11。请在下方选择运行方式。首次使用时会获取预编译的 FlashAttention 3。
安装
git clone https://github.com/statite-ai/SpecAR && cd SpecAR
python3.11 -m venv .venv-krea && source .venv-krea/bin/activate
pip install ".[krea]"
specar download --backbone krea
生成
specar generate --backbone krea \
    --prompt "A papercraft coral reef full of colorful fish" \
    --k 2 --out reef.mp4
需下载约 50 GB。模型加载约 3 分钟后,在 H100 上生成 26.6 秒(426 帧)的视频不到 1 分钟。
安装
git clone https://github.com/statite-ai/SpecAR && cd SpecAR
python3.11 -m venv .venv-helios && source .venv-helios/bin/activate
pip install ".[helios]"
specar download --backbone helios
生成
specar generate --backbone helios \
    --prompt "A papercraft coral reef full of colorful fish" \
    --k 2 --out reef.mp4
两个模型合计需下载约 150 GB,生成时约占用 66 GB 显存。H100 在 --k 2设置下,模型加载约 1 分钟后,可在不到 5 分钟内生成 74 秒(16 FPS、1,185 帧)的视频。
安装
git clone https://github.com/comfyanonymous/ComfyUI && cd ComfyUI
python3.11 -m venv .venv-krea && source .venv-krea/bin/activate
pip install -r requirements.txt "specar[krea] @ git+https://github.com/statite-ai/SpecAR"
git clone https://github.com/statite-ai/ComfyUI-SpecAR custom_nodes/ComfyUI-SpecAR
specar download --backbone krea --weights models/specar/krea
python main.py
生成
打开 http://127.0.0.1:8188,依次进入“Templates” → ComfyUI-SpecAR → SpecAR,输入提示词并点击 Run。如果 ComfyUI 在远程 GPU 机器上运行,请先在自己的电脑上执行:
ssh -L 8188:127.0.0.1:8188 user@your-gpu-machine
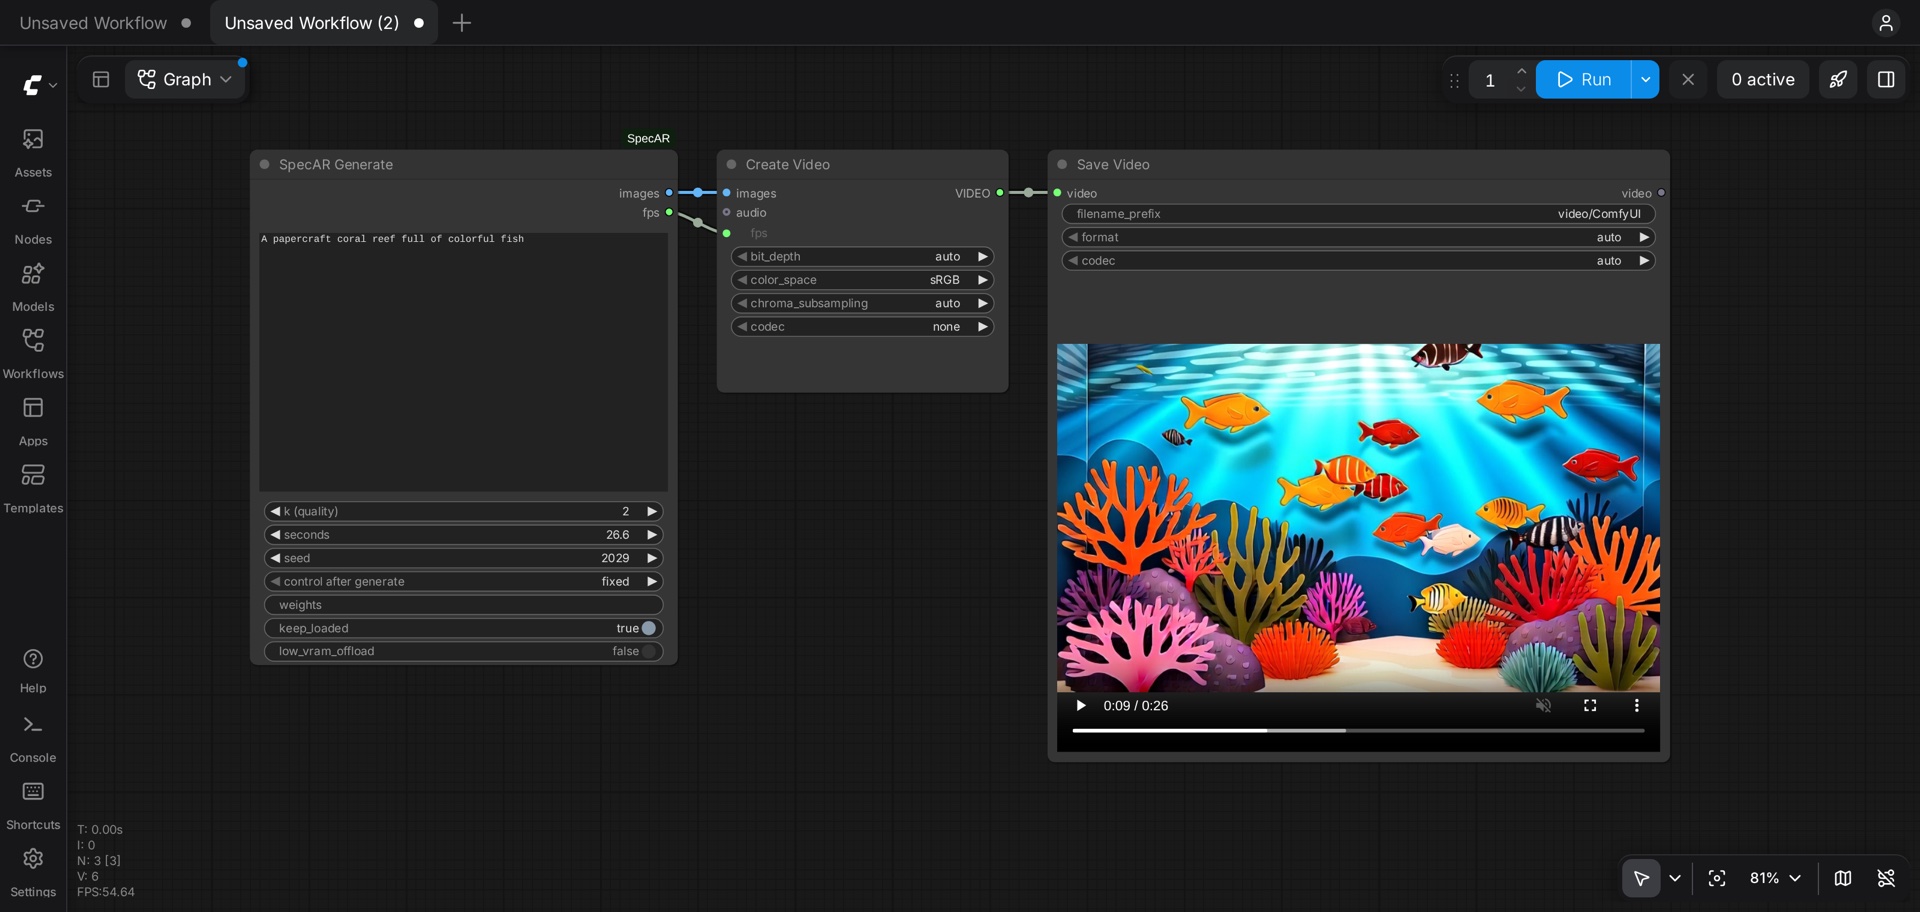
基于 Krea Realtime 14B 运行,约需 45 GB 显存、下载约 50 GB。首次加载模型约需 3 分钟;之后在 H100 上生成并保存一段 26.6 秒的视频约需 1 分钟。
--k 表示目标块数量:2 是论文中最快的设置,7 是默认值。可用 --seconds 设置时长,或用 --example cat体验精选提示词;所有选项见 README.
参考文献
- Hassan, H. (2026). SpecAR:通过分布式目标块加速自回归视频生成. Preprint. H100 benchmarks and routing ablations.
- Hu, Y., & Zhang, J. (2026). Speculative Decoding for Autoregressive Video Generation. arXiv:2604.17397. SDVG baseline.
- Millon, E., & Krea AI. (2025). Krea Realtime 14B: Real-Time, Long-Form AI Video Generation. Model description.
- Yuan, S., et al. (2026). Helios: Real Real-Time Long Video Generation Model. arXiv:2603.04379.
- Huang, X., et al. (2025). Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion. arXiv:2506.08009. Krea drafter.
- Huang, Z., et al. (2024). VBench: Comprehensive Benchmark Suite for Video Generative Models. CVPR 2024.
- Xu, J., et al. (2026). VisionReward: Fine-Grained Multi-Dimensional Human Preference Learning for Image and Video Generation. AAAI 2026.
本页 B200 数据为四个 Krea 提示词的平均值,与预印本中的数据分别测量。
引用本文
@misc{hassan2026specar,
  title  = {SpecAR: Distributed Target Blocks for Fast Autoregressive Video Generation},
  author = {Hassan, Hudeifa},
  year   = {2026},
  note   = {Preprint},
  url    = {https://statite.ai/specar}
}